平台建设方案 A
版本 v1.0 | 编制日期 2026-10-06 | 编制视角 项目经理
资产基线 F:\deepseek-harness\out\...\课外阅读\(语料与结构化数据)、F:\deepseek-harness\08 classic interpretation\(红学史与插图)
0. 一页纸结论
| 项目 | 结论 |
|---|---|
| 一句话定位 | 以脂批可见为核心差异的《红楼梦》版本对照阅读与整本书阅读教学平台 |
| 最稀缺的能力 | 脂批按批型(侧批/眉批/双行夹批/总批)精确锚定到句并可开关对照;程高本与脂评本逐句异文对照 |
| 已有基础 | 内容资产完成度约 70%(原文 173 万字、脂批 3 891 条、结构化数据 7 类、插图 366 张、专题文稿 5 篇) |
| 工程基础 | 0%(尚无前端、无数据库、无语料解析服务) |
| 工作量 | 约 16 周(4 期,单人全职口径;兼职按 ×2.5 计) |
| 现金成本 | 一期 ≈ ¥100/年(域名);含对象存储与 CDN 的完整方案 ≤ ¥600/年 |
| 最大技术风险 | 脂批锚定——批语目前内联在正文流中,须解析为"回/段/句偏移"结构化锚点,是全站体验成立的前提 |
| 最大非技术风险 | 版权合规(点校标点的整理者权利、AI 插图底模许可、语料来源许可)与单人可持续性 |
| 建议首个决策 | 定位选 A(教研优先)还是 B(公众阅读优先)——决定一期是否要做用户系统 |
1. 项目背景与资产盘点
1.1 已有资产(按复用度分级)
A 级:可直接入库,无需再加工
| 资产 | 规模 | 位置 |
|---|---|---|
| 程高本原文 | 120 回/864 530 字 | gitbook-hongloumeng-master\ch_cgb\ |
| 脂评本原文(含内联脂批) | 80 回/866 432 字 | gitbook-hongloumeng-master\ch\ |
| 脂批内联批语 | 3 891 条(庚辰双行夹批 1 132、甲戌侧批 1 124、庚辰侧批 602、蒙侧批 320、甲戌双行夹批 199、庚辰眉批 138 等) | 同上,形态为 ```(甲戌侧批:…)``` |
| 两版全部回目 | 200 条 | 证据数据\titles.json |
| 人物关系 | 75 条关系记录、40 人 | 红楼梦人物关系图谱\relations.json |
| 人物章回密度矩阵 | 40 人 × 120 回 | 红楼梦人物关系图谱\presence.json |
| 戏曲曲目 | 47 条(回次·场合·点戏人·剧目·作用) | 证据数据\drama.json |
| 命运事件 | 280 条 | 证据数据\fate.json |
| 岁时节令 | 元宵 7、中秋 7、清明 5、冬至 2、腊月 4 等 | 证据数据\festival.json |
| 人物时间线 | 每人物 7 项节点 | 证据数据\character_timeline.json |
| 全文证据库 | 1.41 MB | 证据数据\evidence.json |
| 公版画作 | 48 张(含改琦《红楼梦图咏》全帙,1879 年,已过保护期) | 08 classic interpretation\...\插图\参考画作\ |
| 人物图谱与章回热力图 | 4 个文件(PNG+SVG,矢量可直接用于网页) | 红楼梦人物关系图谱\ |
B 级:内容已成型,需转成结构化数据后才可复用
| 资产 | 规模 | 网页化要做的加工 |
|---|---|---|
| 《人物一页纸》40 人 | 32 905 字符 | 拆成 40 个人物 JSON:身份/解读/脉络/情节四段 |
| 主要人物命运时间线 | 5 019 字符 | 与 fate.json 合并去重 |
| 戏曲曲目及主要情节 | 4 538 字符 | 与 drama.json 合并,补剧目→剧种映射 |
| 明确时间的故事与索隐派解读 | 4 748 字符 | 须按"文本事实/后人推论/索隐派主张"三栏结构化,不可混排 |
| 红学史与矛盾结构对照表 | 附 2 张图 | 转为专题长文 |
| AI 生成插图 | 366 张/约 245 MB(SD1.5、SDXL、国风 3、明代 LoRA、ControlNet、连环画版等) | 需逐张登记底模与许可、统一转 WebP、裁切多规格 |
C 级:管线原型可产品化
现有 20 个 Python 脚本中,可直接升格为内容管线的:
| 脚本 | 升格后的角色 |
|---|---|
extract_evidence.py | 全文统计与批语抽取(构建期批处理) |
extract_titles.py | 回目与判词抽取 |
extract_topics.py | 戏曲/节令/命运事件抽取 |
build_graph_data.py | 人物共现与关系计算 |
verify_quotes_new20.py | 引文核验门禁(CI 中运行,防止错引上线) |
verify_40.py / verify_onepager.py | 交付物完整性门禁 |
核验资产特别说明:本项目已形成一套"引文必回原文机器比对"的做法(114 处引号片段逐条检索 173 万字语料,订正 35 处)。这套脚本应升格为上线前强制门禁——这是本平台相对同类站点的可信度护城河,建议在页面上明示"每句引文均可溯源"。
1.2 就绪度总评
| 维度 | 就绪度 | 说明 |
|---|---|---|
| 原文语料 | 95% | 齐备;待确认来源许可 |
| 脂批数据 | 70% | 条数齐备;锚点位置未结构化(核心待办) |
| 人物数据 | 85% | 图谱、密度、一页纸齐备;待合并为统一人物库 |
| 专题内容 | 80% | 五篇文稿成型;待三栏结构化 |
| 图像资产 | 60% | 量大;待许可登记与格式优化 |
| 工程实现 | 0% | 前端、后端、部署均未开始 |
结论:本项目不是从零开始的内容项目,而是一个"内容已囤积、待工程化"的项目。风险重心不在内容生产,而在把已有内容转成可持续维护的数据结构。
2. 定位与差异化
2.1 同类产品与空白
| 类型 | 代表 | 已做得好的 | 明显空白 |
|---|---|---|---|
| 公版文库 | 维基文库、中国哲学书电子化计划 | 原文稳定、可引用 | 无脂批、无人物数据、无教学结构 |
| 阅读 App | 各类"四大名著"App | 阅读体验、朗读 | 脂批被省略或混排;无版本对照 |
| 红学数据库 | 各类脂批检索工具 | 批语检索 | 面向研究者,界面门槛高;无教学场景 |
| 教辅站点 | 各校自建专题页 | 贴合考点 | 静态 PDF/Word,无交互,无数据 |
空白点:面向"整本书阅读"教学的、脂批可见可开关、且人物与情节数据可交互的平台,目前没有成熟产品。
2.2 三条定位路线
| 路线 | 定位 | 一期核心 | 优 | 劣 |
|---|---|---|---|---|
| A 教研优先 | 高中整本书阅读教学平台 | 原文+脂批对照+人物/情节数据+专题(对应现有 5 篇文稿) | 与现有资产 100% 对齐,一期即完整可用;无用户系统,成本极低 | 受众窄,增长慢 |
| B 公众阅读优先 | 大众在线阅读与赏析产品 | 精排原文+注释+插图+音频+社区 | 流量潜力大;366 张插图有用武之地 | 需用户系统、审核、运营;与现有资产匹配度约 50% |
| C 研究工具 | 红学版本考据数据库 | 版本异文全库、脂批全文检索、影印对照 | 学术价值高,稀缺性最强 | 用户极少;异文校对工作量极大 |
2.3 推荐:A 为骨、C 为魂、B 为翼
一期按 A 落地(把已有资产全部产品化,不新增内容负担);把 C 的两个杀手级功能(脂批按型锚定、版本异文对照)作为一期差异化卖点——因为它们的技术基础(内联批语、双版本语料)已经在手;B 的插图与音频留到二期,作为传播与留存手段,不做社区。
一期不做用户系统。 理由:MVP 阶段用户系统不产生价值,却带来注册、找回、隐私合规、数据存储四类成本;用浏览器本地存储(收藏/笔记)即可满足个人使用。
3. 目标用户与核心场景
| 用户 | 占比预估 | 核心场景 | 对应功能 |
|---|---|---|---|
| 语文教师 | 40% | 备课要点开某回,看脂批怎么评、哪几回是盛衰分水岭 | 脂批对照、章回脉络、专题检索、导出打印 |
| 高中生 | 35% | 读原文明人物关系,查"这个人哪几回出现" | 人物图谱、一页纸、情节脉络、白话对照 |
| 红学爱好者 | 20% | 比对两版异文,查某条批语出自哪本 | 版本异文对照、脂批检索、批型筛选 |
| 研究者 | 5% | 精确引用,需要可溯源 | 引文溯源、稳定 URL、数据导出 |
三条关键动线(一期必须走通)
- 读:
首页 → 章回目录 → 第 46 回正文 → 点句子上的批语标记 → 侧栏展开甲戌侧批 → 切换显示"仅庚辰批" → 跳转"鸳鸯"人物页 - 查:
搜索框输入"乌眼鸡" → 命中第 75 回原文+相关批语 → 定位到该句 - 教:
专题页"盛衰分水岭" → 第 63 回与第 74 回对照 → 下载该专题 Word/打印
4. 范围定义
4.1 一期(MVP)范围——P0
| 编号 | 功能 | 说明 |
|---|---|---|
| F1 | 原文阅读器 | 两版切换;程高本 120 回+脂评本 80 回;分回、分页、目录、阅读进度 |
| F2 | 脂批对照 | 批型筛选(侧批/眉批/夹批/双行夹批/总批)、开关、侧栏与行内两种呈现 |
| F3 | 版本异文对照 | 前 80 回逐句对齐,差异高亮;程高本仅本回、脂评本缺失回明确标注 |
| F4 | 人物库 | 40 人详情页(身份/解读/脉络/情节)+ 交互式人物关系图谱 |
| F5 | 章回脉络可视化 | 40 人 × 120 回密度热力图,可点选人物高亮 |
| F6 | 全文检索 | 原文+脂批+专题;支持按版本与批型过滤 |
| F7 | 专题栏 | 命运时间线/戏曲曲目/明确时间与索隐派/红学史,共 4—5 篇 |
| F8 | 引文溯源 | 每条引文可跳原文位置;显示核验状态 |
| F9 | 本地收藏与笔记 | 浏览器本地存储,无账号 |
4.2 明确不做(Out of Scope)
| 不做 | 理由 |
|---|---|
| 用户注册/登录/社交 | 一期无价值,成本高 |
| 社区/评论/UGC | 需审核与运营,单人不可持续 |
| 移动 App | 响应式 Web 已覆盖;App 上架与更新成本高 |
| 影印本图版对照 | 影印件版权与体量均不可控(见 §12) |
| AI 续写/AI 问答 | 与"可信溯源"定位冲突;幻觉风险高 |
| 全 120 回逐句异文对齐 | 后 40 回无脂本可比,一期只做前 80 回 |
5. 信息架构与站点地图
5.1 五大内容域
/ 首页(今日一回 · 数据总览 · 三条动线入口)
├── /read            原文阅读
│   ├── /read/cgb/1            程高本 第 N 回
│   ├── /read/zp/1             脂评本 第 N 回
│   └── /read/compare/1        ★ 异文对照(前 80 回)
├── /people          人物
│   ├── /people                人物总览(卡片墙 + 检索)
│   ├── /people/鸳鸯           人物详情(一页纸 + 出场回次 + 关系子图)
│   └── /people/graph          交互式关系图谱
├── /special         专题
│   ├── /special/fate-timeline     主要人物命运时间线
│   ├── /special/drama             戏曲曲目与伏笔
│   ├── /special/dates             明确时间的故事与索隐派解读
│   └── /special/redology          红学史与矛盾结构
├── /timeline        章回脉络(40×120 热力图)
└── /search          全文检索
5.2 页面清单与优先级
| 页面 | 优先级 | 数据依赖 | 预估工时 |
|---|---|---|---|
| 回目目录 + 阅读器 | P0 | titles.json、两版正文 | 3 周 |
| 脂批对照面板 | P0 | 批语锚点(待建) | 2 周 |
| 异文对照视图 | P0 | 句级对齐(待建) | 2 周 |
| 人物详情页 ×40 | P0 | 一页纸 §B + presence.json | 2 周 |
| 关系图谱 | P0 | relations.json | 1.5 周 |
| 章回热力图 | P1 | presence.json | 1 周 |
| 全文检索 | P0 | 索引(构建期生成) | 1.5 周 |
| 专题页 ×4 | P1 | 文稿 §B | 2 周 |
| 首页 | P1 | 聚合 | 0.5 周 |
5.3 关键设计原则
- 原文永远是主角:批语、注释、图谱一律不遮挡正文;默认脂批收起。
- 一切可溯源:任一引文右侧可点"原文位置";专题页每条主张标注"文本事实/后人推论/索隐派主张"。
- 不伪装确定性:两版差异、脂本阙回、有争议处(如"虎兕相逢"↔第 95 回"已交卯年寅月")直白标注,不做单一叙事。
6. 数据工程(本项目真正的难点)
6.1 核心数据模型(7 张表)
-- 1. 回目
chapter(version TEXT, no INT, title TEXT, char_count INT, PRIMARY KEY(version, no))
-- version ∈ {cgb(程高本), zp(脂评本)}

-- 2. 段落 / 句子(异文对齐的最小单元)
segment(id INT PK, version TEXT, chapter_no INT, para_idx INT,
        sent_idx INT, text TEXT, align_id INT NULL)   -- align_id 跨版本同一句

-- 3. ★ 脂批锚点(本项目最关键的表)
comment(id INT PK, chapter_no INT, seg_id INT, char_offset INT,
        ctype TEXT, source TEXT, text TEXT)
-- ctype ∈ {侧批, 眉批, 夹批, 双行夹批, 总批, 回前批, 回后批}
-- source ∈ {甲戌, 庚辰, 蒙府, 己卯, 靖藏, 戚序}

-- 4. 人物
person(id TEXT PK, name TEXT, aliases TEXT, identity TEXT,
       verdict TEXT, verdict_note TEXT, reading TEXT, meta JSON)

-- 5. 人物出场密度
presence(person_id TEXT, seg20 INT, count INT, PRIMARY KEY(person_id, seg20))

-- 6. 人物关系
relation(a TEXT, b TEXT, kind TEXT, evidence_chapter INT, weight INT)

-- 7. 事件(命运/戏曲/节令/明确日期 四类合一)
event(id INT PK, kind TEXT, person_id TEXT NULL, chapter_no INT,
      date_text TEXT NULL, summary TEXT, quote TEXT, quote_seg_id INT NULL,
      claim_type TEXT)   -- claim_type ∈ {文本事实, 后人推论, 索隐派主张}
第 7 表的 claim_type 是本方案的方法论核心:索隐派主张与文本事实在同一张表里但字段分开,前端可一键筛选,避免混排。
6.2 脂批锚定——全站最关键的技术任务
问题:脂批目前内联在正文流里,形如:
贾政忽想起他来,方喝道:"你还不去?难道还逛不足!
```(庚辰侧批:冤哉冤哉!)```也不想逛了这半日…"批语的位置信息是隐含在字符流中的,且一条批语可能锚在句中、句末或段末;(甲戌侧批:…) 与 (庚辰双行夹批:…) 的语义位置(侧批常在句末、双行夹批常在小句末)也不同。直接渲染会丢失"这句被批了"这一最核心的阅读体验。
方案:构建期一次性解析,输出结构化锚点。
- 切分:按
----与空行切段落;段落内按中英文标点切句;记录每句的char_offset。 - 抽取:正则
```\((?P<source>[^::]*?)批[::](?P<text>.*?)```抽出source/text,并从source解析批型与版本(如"庚辰双行夹批"→ source=庚辰, ctype=双行夹批)。 - 定位:批语标记在字符流中的位置 → 映射到所属句的
seg_id与句内偏移。 - 校验:解析后回写重建正文,与原始文件逐字 diff 必须为 0(除批语标记本身);批语条数必须等于 3 891。此校验不通过则构建失败。
验收标准
| 指标 | 目标 |
|---|---|
| 批语条数 | 3 891 条,一条不丢 |
| 定位准确率(人工抽检 200 条) | ≥ 98% 锚定到正确句 |
| 正文重建 diff | 0 字节差异 |
| 批型分类正确率 | ≥ 99% |
风险提示:蒙府本与庚辰本在第 18 回等处的分回不同(语料中已有说明"庚辰本无此回,照蒙本在此分作两回"),锚点表须带 source 字段,否则跨版本锚定会错位。
6.3 版本异文对齐
- 算法:按回对齐 → 段级用最长公共子序列(LCS)粗对齐 → 句级用编辑距离细对齐 → 输出
align_id。不用大模型:173 万字、句子规整,传统 diff 已足够,且结果可复现、可人工复核。 - 产出:前 80 回异文表(预计 8 000—20 000 处,以实际构建为准),按"用字/用词/增删句/整段差异"分级。
- 呈现:并列双栏 + 差异高亮;脂本阙回(后 40 回)显示"此回脂评本无"而非空白。
6.4 内容管线(把已有脚本产品化)
源语料 (ch_cgb/, ch/)
   │  ① parse_corpus.py      切段切句 → 脂批抽取 → 锚点定位
   ▼
规范化中间层 (JSONL)
   │  ② build_entities.py    一页纸文稿 + 已有 7 类 JSON → 人物库/事件库
   │  ③ align_versions.py    双版本句级对齐
   │  ④ verify_quotes.py  ← ★ 门禁:全部引文回原文机器比对
   ▼
SQLite (content.db)  ──⑤ index_build.py──▶  静态索引 (Pagefind)
   │  ⑥ export_site_data.py  导出构建期 JSON
   ▼
站点构建 (Astro) ──▶ 静态产物 ──▶ CDN设计目标:新增一位人物、一篇专题,应当是改一个 YAML/Markdown 文件,而不是写代码。这是单人项目能否持续的唯一保障。
6.5 数据质量门禁(CI 必过项)
| 门禁 | 规则 |
|---|---|
| 引文核验 | 所有引号内文字必须在语料中命中;未命中则构建失败 |
| 批语完整性 | 条数 = 3 891;正文重建 diff = 0 |
| 主张分栏 | 每条 event 必须填 claim_type,不得为空 |
| 人物一致性 | 一页纸 40 人与图谱 40 人差异须显式登记(现为:图谱含紫鹃不含惜春,一页纸含惜春不含紫鹃) |
| 链接完整性 | 站内链接无死链;跨版本跳转目标存在 |
7. 技术架构
7.1 选型对比
| 方案 | 优 | 劣 | 结论 |
|---|---|---|---|
| Astro(SSG)+ 构建期 JSON + Pagefind + D3/ECharts islands | 零后端、零运维、秒开、SEO 好、可长期存活;岛屿架构只在需要交互处加载 JS | 无服务端动态能力 | ✅ 推荐 |
| Next.js(SSR) | 动态能力强,易加用户系统 | 需常驻服务;173 万字首屏渲染成本高;运维负担 | 二期若做用户系统再考虑 |
| 现成 CMS(WordPress 等) | 上手快 | 正文与脂批的结构化锚点无法用 CMS 原生表达;性能与安全维护成本高 | ✗ |
| 纯静态 HTML 手写 | 最简单 | 120 回×2 版本+40 人物页无法手工维护 | ✗ |
推荐栈
| 层 | 选型 | 理由 |
|---|---|---|
| 站点框架 | Astro 5 | 内容型站点首选;默认零 JS,岛屿按需 |
| 样式 | Tailwind CSS | 排版变量化,便于做"古籍风"主题 |
| 数据构建 | Python 3.12 + SQLite | 直接复用已有 20 个脚本与 证据数据\ |
| 检索 | Pagefind(构建期生成静态索引) | 无后端;支持中文;可做版本/批型过滤 |
| 可视化 | ECharts(热力图)+ D3-force / Cytoscape.js(关系图) | 已有 SVG 可作降级;中文标签渲染可靠 |
| 图像 | WebP/AVIF + srcset | 245 MB 原始图必须优化后上线 |
| 部署 | Cloudflare Pages(+ R2 存图) | 免费额度足够;全球 CDN;自定义域名 |
为什么不上 Elasticsearch:全库仅约 173 万字(纯文本 ~3.5 MB 索引量),Pagefind 与 SQLite FTS5 均游刃有余。上 ES 属于典型的过度设计。
7.2 系统架构图
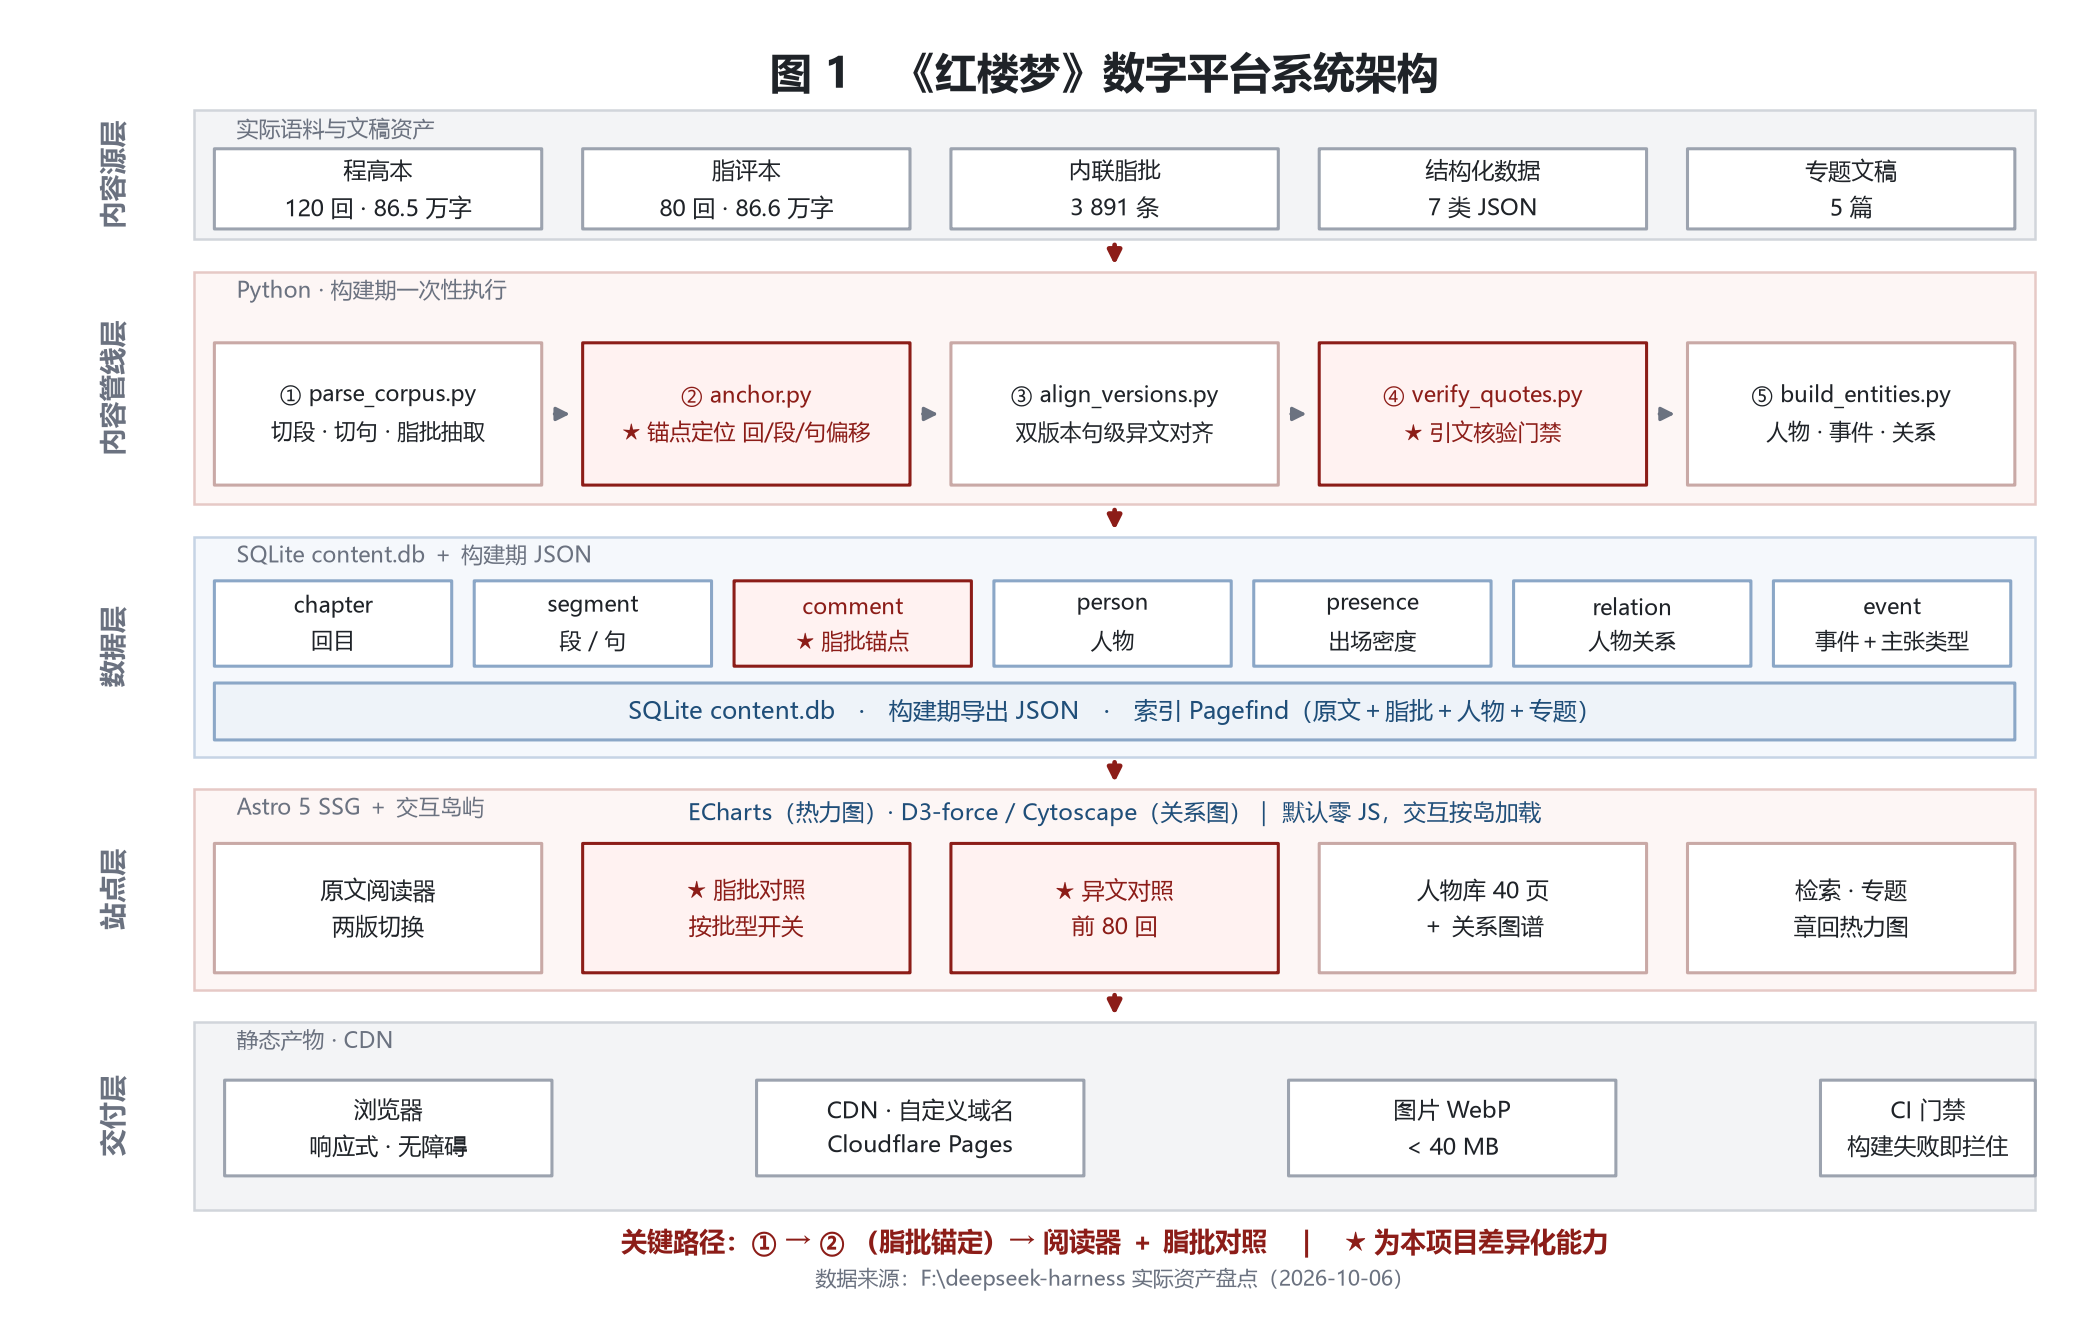
图 1 《红楼梦》数字平台系统架构
架构的读法:上下是五层,核心在第 2、3 层之间的两次"★"。全站体验能否成立,取决于内容管线层能否把内联脂批解析成"回/段/句偏移"并以 comment 表入库——这一步做完,脂批对照与异文对照两个差异化功能才谈得上实现;做不完,后面所有页面都只能退化为"没有批语的普通阅读器"。
7.3 检索方案
| 项 | 方案 |
|---|---|
| 索引对象 | 程高本正文、脂评本正文、脂批 3 891 条、人物 40 条、专题文稿 5 篇 |
| 分词 | 中文按双字 bigram 为主(无需词典、召回稳定);"乌眼鸡""木石前盟"等专名放白名单优先精确匹配 |
| 过滤维度 | 版本(程高/脂评)、批型、人物、回次区间、主张类型 |
| 排序 | 精确短语 > 全词命中 > 部分命中;同分按回次升序 |
| 体验 | 结果页显示上下文片段并高亮;点击直接定位到原句(利用 seg_id) |
7.4 可视化方案
| 图 | 数据 | 交互 |
|---|---|---|
| 人物关系图谱 | relations.json(40 人/75 条) | 悬停高亮邻接、点击进人物页、按关系类型过滤、力导向布局可拖拽 |
| 章回脉络热力图 | presence.json(40×120) | 对数色阶(原图已用 LogNorm);点人物聚焦单行;点回次跳正文 |
| 人物命运时间线 | fate.json(280 条)+character_timeline.json | 横向时间轴,按人物泳道;节点可点开原文 |
| 异文对照 | 对齐表 | 双栏同步滚动、差异高亮、仅看差异开关 |
7.5 非功能指标
| 指标 | 目标 |
|---|---|
| 首屏 LCP(4G) | < 1.5 s |
| 单回页面 JS | < 80 KB(gzip) |
| 单回页面体积 | < 250 KB(含图) |
| 图片总量 | 245 MB → < 40 MB(WebP,多规格) |
| 可访问性 | 正文对比度 ≥ 4.5:1;全站键盘可达;语义化标题层级 |
| SEO | 每回独立 URL 与描述;结构化数据标注;sitemap.xml |
| 引用稳定性 | 段落级锚点 URL(/read/cgb/46#p12s3)永久不变 |
8. 实施计划
8.1 四期里程碑
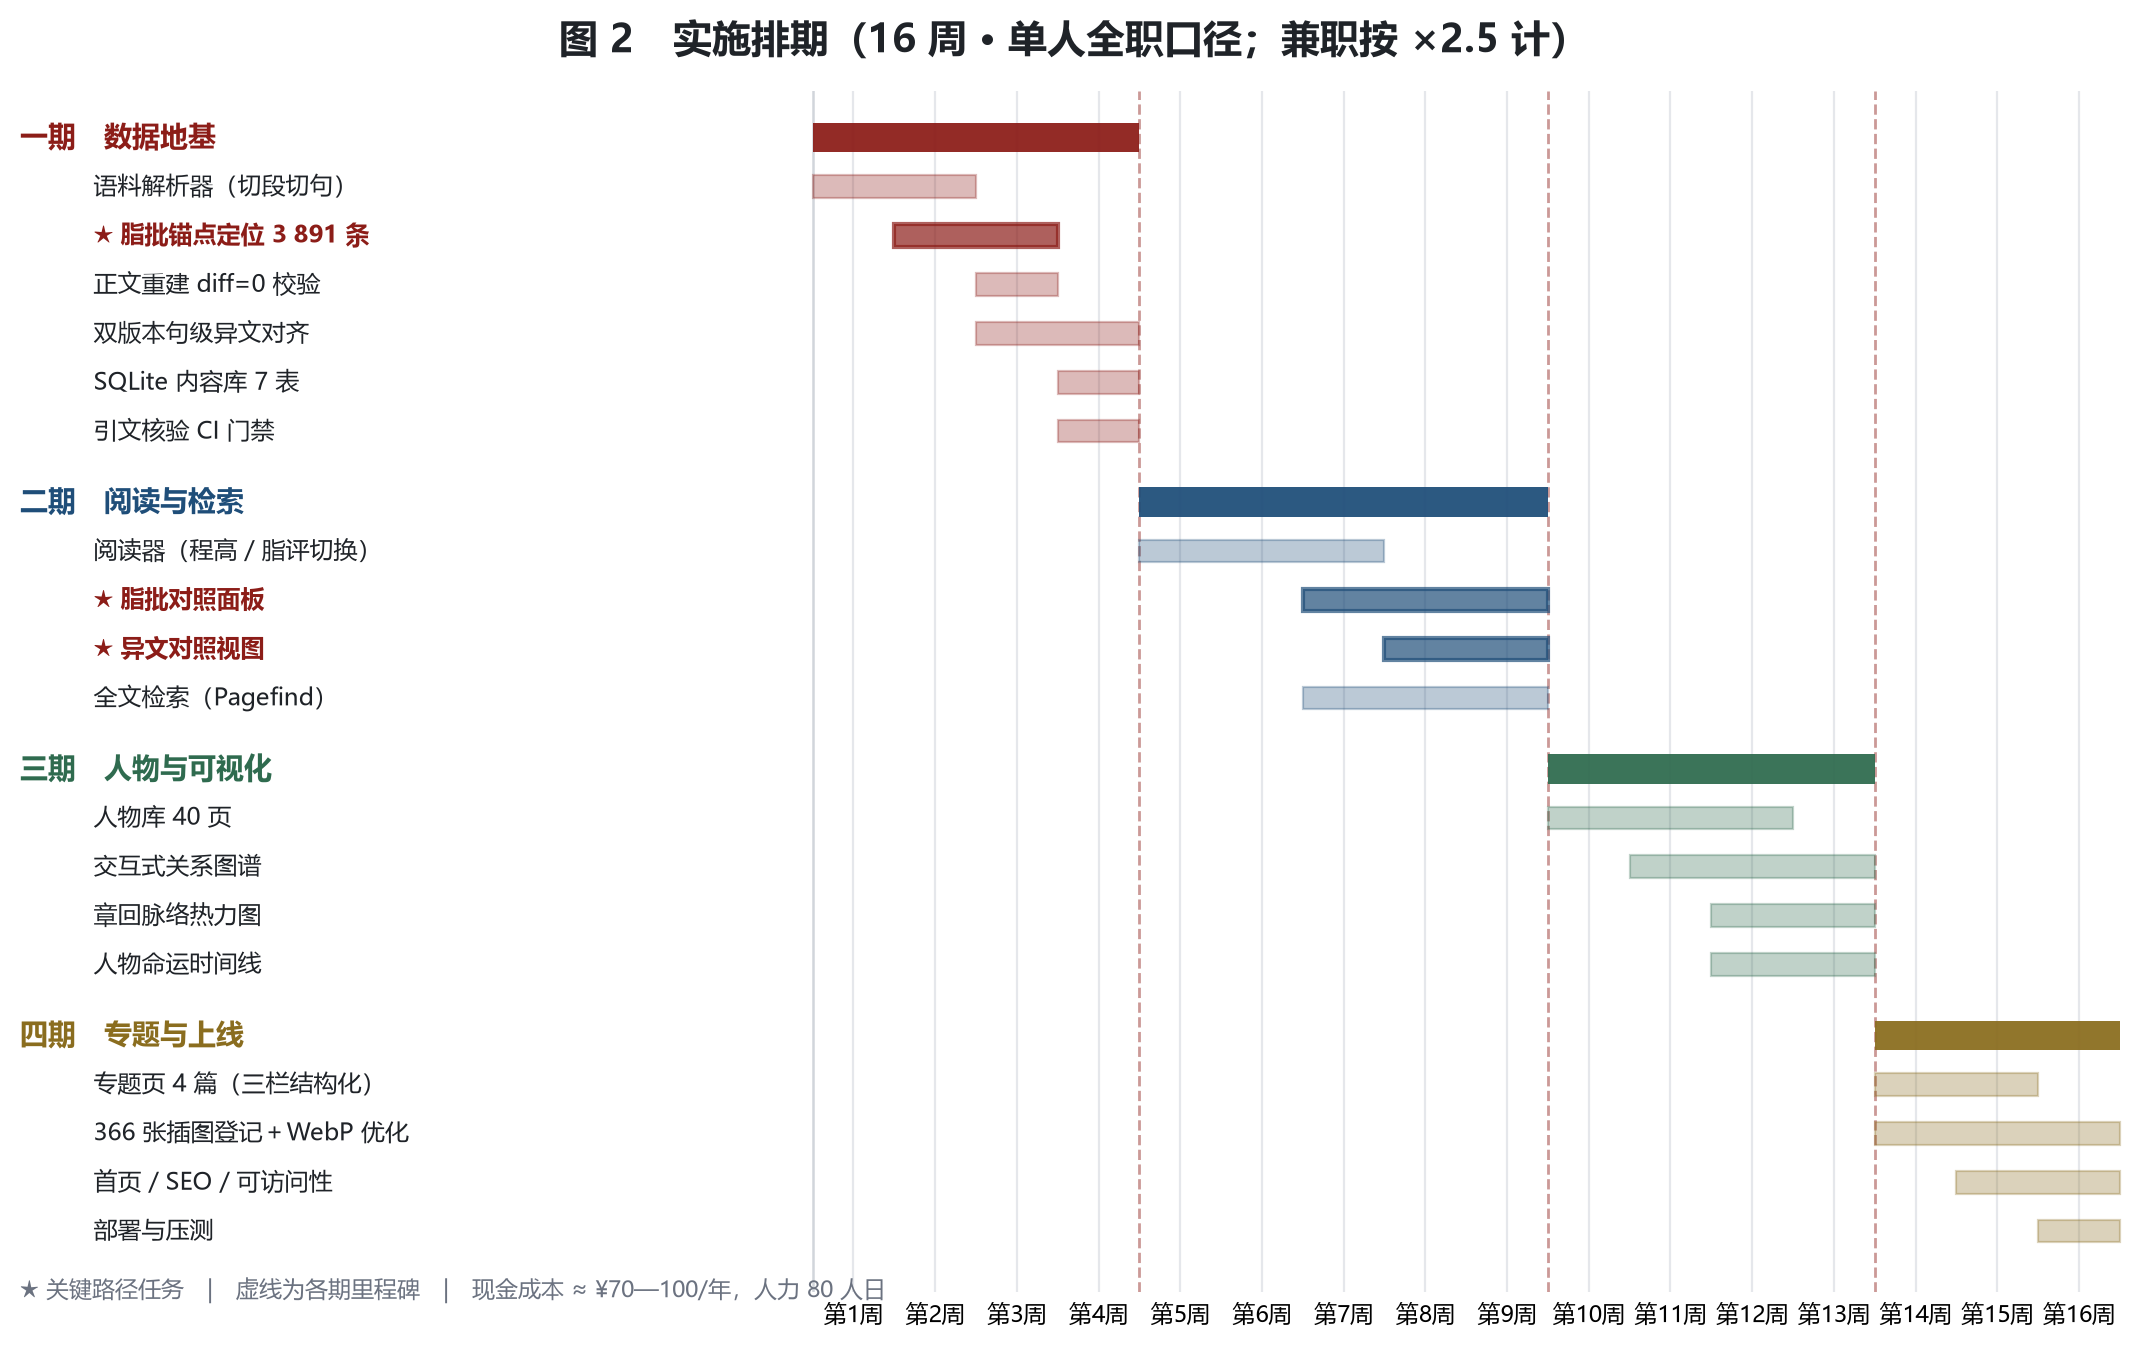
图 2 实施排期(16 周 · 单人全职口径)
排期要点:一期(第 1—4 周)没有任何用户可见成果,却是唯一不可压缩的阶段。6 项任务中 4 项集中在第 3—4 周,其中"脂批锚点定位"与"正文重建 diff=0 校验"互为依赖——锚点解析错一位,重建 diff 就不可能为 0,反之 diff 为 0 就基本证明解析无损。这是本方案设计的自证机制:用一条可自动执行的校验替代人工逐条核对。
若为兼职投入(按 ×2.5 计约 40 周),建议在一期结束后先上线"阅读器"单功能版本(可读原文、无脂批),让成果尽早可用,再继续二期。
| 期 | 周期 | 主题 | 关键交付 |
|---|---|---|---|
| 一期 | 第 1—4 周 | 数据地基 | 语料解析器、脂批锚点表(3 891 条)、异文对齐、SQLite 内容库、质量门禁 CI |
| 二期 | 第 5—9 周 | 阅读与检索 | 阅读器(两版)、脂批对照面板、异文对照视图、全文检索、回目目录 |
| 三期 | 第 10—13 周 | 人物与可视化 | 人物库 40 页、关系图谱、章回热力图、命运时间线 |
| 四期 | 第 14—16 周 | 专题、图像与上线 | 专题页 4 篇、366 张插图登记与优化、首页、SEO、部署与压测 |
8.2 各期验收标准(DoD)
一期
- [ ] 解析器输出
content.db,含 7 张表 - [ ] 脂批 3 891 条全部入库,抽检 200 条锚定准确率 ≥ 98%
- [ ] 正文重建与源文件 diff = 0
- [ ] 前 80 回异文对齐完成,可导出异文表
- [ ] CI 门禁脚本
verify_quotes.py接入,构建失败可复现
二期
- [ ] 三条关键动线(读/查/教)全部走通
- [ ] 脂批可按批型开关;行内标记与侧栏联动正确
- [ ] 检索覆盖 4 类内容;中文专名命中率人工抽检 ≥ 95%
- [ ] 单回页面 LCP < 1.5 s(4G 模拟)
三期
- [ ] 40 个人物页数据完整、无空缺字段
- [ ] 关系图谱 40 节点/75 条关系全可交互
- [ ] 热力图与原文跳转无误
- [ ] 人物名录差异(惜春/紫鹃)在页面上有明确说明
四期
- [ ] 专题 4 篇上线,每条主张带类型标注
- [ ] 366 张插图完成许可登记;总计 < 40 MB
- [ ] 全站无死链;Lighthouse 性能与可访问性 ≥ 90
- [ ] 部署完成,自定义域名可访问,HTTPS 正常
8.3 关键路径
语料解析 + 脂批锚定(一期,不可压缩)
        ↓
阅读器 + 脂批对照(二期)        ← 关键路径,任何延迟直接顺延上线
        ↓
上线(四期)关系图谱、热力图、专题页不在关键路径上,可在二期并行开展,用已有 SVG 先上线降级版本。若人力紧张,优先保关键路径。
9. 团队与角色
| 角色 | 单人项目折算 | 职责 |
|---|---|---|
| 项目经理 | 10% | 范围控制、里程碑、风险 |
| 数据工程师 | 30% | 语料解析、脂批锚定、异文对齐、检索索引 |
| 前端工程师 | 40% | 阅读器、可视化、性能与可访问性 |
| 内容编辑 | 15% | 人物栏、专题整理、主张分栏、引文核验 |
| 视觉/插图 | 5% | 插图登记与裁切、古籍风主题(插图不新生成,只筛选已有 366 张) |
单人全职约 16 周;若每周投入 10 小时(兼职),按 ×2.5 计约 40 周。建议兼职口径下把一期做扎实,二期以后可分批上线(先上"读",再上"人物")。
10. 成本估算
10.1 现金成本
| 项目 | 一期 | 完整方案 | 说明 |
|---|---|---|---|
| 域名 | ¥70/年 | ¥70/年 | .com 或 .cn |
| 托管(Cloudflare Pages) | ¥0 | ¥0 | 免费额度:500 次构建/月、无限请求、100 GB/月带宽 |
| 对象存储(图片) | ¥0(图片 < 500 MB 可随站部署) | ¥0—¥300/年 | 若用 R2,免费 10 GB+零出口费 |
| HTTPS/CDN | ¥0 | ¥0 | 含在 Pages 内 |
| 字体 | ¥0 | ¥0 | 使用开源中文字体(思源宋体/霞鹜文楷),注意 Web 字体子集化 |
| 合计 | ≈ ¥70—100/年 | ≤ ¥600/年 | 不含人力 |
10.2 人力成本(按 16 周单人全职折算)
| 阶段 | 人日 |
|---|---|
| 一期 数据地基 | 20 |
| 二期 阅读与检索 | 25 |
| 三期 人物与可视化 | 20 |
| 四期 专题与上线 | 15 |
| 合计 | 80 人日 |
成本优势结论:本项目是典型的"内容已备、只欠工程"项目,现金投入近乎为零,主要成本是 80 人日 的工程实现。因此排期风险远大于预算风险。
11. 风险登记册
| 编号 | 风险 | 概率 | 影响 | 应对 |
|---|---|---|---|---|
| R1 | 脂批锚定不准(侧批/夹批位置误判)导致核心体验失效 | 中 | 高 | 一期先做,人工抽检 200 条;锚点表保留 char_offset 原始值以便回溯;降级方案:只按段落锚定(精度降低但必可用) |
| R2 | 版权合规:点校标点的整理者权利、AI 插图底模许可、语料来源许可 | 中 | 高 | 见 §12;上线前完成许可登记表;不确定的一律不上线 |
| R3 | 蒙府/庚辰分回不同导致跨版本锚点错位 | 中 | 中 | 锚点表带 source;分回差异在语料中已注明,解析时显式处理 |
| R4 | 366 张插图体积过大拖垮性能 | 高 | 中 | 上线前统一 WebP 化并生成 3 档尺寸;一期只放 40—60 张精选 |
| R5 | 单人可持续性:二期后动力衰减 | 高 | 高 | 内容管线化(改 YAML 即可加内容);四期分批上线,每期都有可用产物,避免"半年后才有东西" |
| R6 | 范围蔓延(想加社区、AI 问答、App) | 高 | 中 | §4.2 明确不做清单;变更须书面记录并同步调整排期 |
| R7 | 检索中文分词效果差 | 中 | 低 | bigram 为主 + 专名白名单;不引入词典依赖 |
| R8 | 后 40 回无脂本可比,用户误以为"功能缺失" | 中 | 低 | 界面明确提示"此回脂评本无",并说明原因 |
| R9 | 引文错引上线损害可信度 | 低 | 高 | 引文核验作为 CI 强制门禁(已有脚本原型,且已实际订正 35 处错引) |
| R10 | 开源依赖长期失维 | 低 | 中 | 选用 Astro/Pagefind/ECharts 等主流长期项目;静态产物本身不依赖服务存活 |
12. 版权与合规(上线前必须清零)
| 对象 | 状况 | 须做的动作 |
|---|---|---|
| 《红楼梦》程高本原文 | 1791/1792 年刊行,进入公有领域 | 无 |
| 脂评本正文(甲戌、庚辰、蒙府等) | 抄本本身公有领域 | 无 |
| 点校、标点、校注 | ⚠️ 整理者对其点校成果可能享有著作权 | 核对本项目语料来源;如来自某点校本,须取得授权或改用自校文本并明确标注;不得直接复制商业点校本的标点与校注 |
| gitbook 版语料仓库 | ⚠️ 许可未确认 | 查证仓库 LICENSE;若无可授权声明,须替换语料来源或自行转录 |
| 改琦《红楼梦图咏》(1879) | 公有领域 | 可自由使用,标注出处为佳 |
| 其它 47 张参考画作 | 需逐张确认 | 建立"作者—年代—来源 URL—许可"登记表;存疑者不用 |
| 366 张 AI 生成插图 | ⚠️ 分层许可 | ① 生成工具链:Stable Diffusion 1.5 采用 CreativeML OpenRAIL-M(允许商用,含使用限制条款);SDXL 许可须单独核对;② 底模 majicmix、GuoFeng3、社区 LoRA(hanfu 系列)各有来源许可,须逐项登记;③ 若含真人风格肖像或他人作品特征,另需评估。未完成登记的图片不得上线 |
| 站点自身代码与文稿 | 自有 | 建议以 MIT(代码)+ CC BY-NC-SA 4.0(内容)开源,明确二次使用规则 |
| 隐私 | 一期无账号、无追踪 | 不设 Cookie 追踪;如加统计,用隐私友好方案(如 Cloudflare Web Analytics) |
PM 判断:R2 是唯一可能让项目整体推倒重来的风险。建议在第 1 周就把许可登记表建起来、把语料来源查清,而不是等到四期上线前——越晚发现,返工越大。
13. 成功指标
| 层级 | 指标 | 一期目标 | 一年目标 |
|---|---|---|---|
| 交付 | 关键动线走通 | 3/3 | 3/3 |
| 交付 | 数据完整度 | 脂批 100% 锚定 | 异文表覆盖前 80 回 |
| 质量 | 引文核验通过率 | 100%(CI 强制) | 100% |
| 质量 | 性能(LCP) | < 1.5 s | < 1.2 s |
| 使用 | 单次访问回数 | — | ≥ 3 回/次 |
| 使用 | 检索使用率 | — | ≥ 25% 会话 |
| 影响 | 被教学引用 | — | ≥ 5 所学校/机构使用 |
| 可持续 | 新增内容的代码改动量 | — | 0 行代码(仅改 YAML/MD) |
14. 下一步:第 1 周即可执行的 8 件事
| # | 事项 | 产出 | 负责角色 |
|---|---|---|---|
| 1 | 查证语料来源许可(gitbook 仓库 LICENSE、是否点校本) | 语料合规结论 | PM+内容 |
| 2 | 建立插图许可登记表(366 张,逐张) | licenses.csv | 视觉+PM |
| 3 | 写 parse_corpus.py:切段切句 + 脂批抽取 | 中间层 JSONL | 数据 |
| 4 | 实现脂批锚点定位与"正文重建 diff=0"校验 | 锚点表 + 校验报告 | 数据 |
| 5 | 跑通 Pagefind 中文检索原型(100 回样本) | 可用检索 demo | 前端 |
| 6 | 搭 Astro 骨架+阅读器静态页(3 回样本) | 可点原型 | 前端 |
| 7 | 把 5 篇专题文稿按"文本事实/后人推论/索隐派主张"三栏结构化 | 4—5 个 YAML | 内容 |
| 8 | 定人物名录差异(图谱含紫鹃/一页纸含惜春)并统一 | 统一人物主表 | PM+内容 |
第 3、4 项是关键路径的第一个卡点:这两件事做完,全站体验的地基就成了;做不完,后面所有页面都只能做"没有批语的普通阅读器"。
本方案基于 F:\deepseek-harness 下已完成的语料、结构化数据与文稿资产编制。所有规模数字(回数、字数、批语条数、图片张数)均来自实际盘点,未作估算。